达观数据近期在IEEE知识工程与数据管理国际期刊发表题为《MLSA4Rec: Mamba Combined With Low-Rank Decomposed Self-Attention for Sequential Recommendation》的高水平科研论文。
1. 研究背景与问题定义序列推荐系统是现代推荐系统的重要分支,广泛应用于电子商务、在线教育和流媒体服务等场景。其核心任务是基于用户的历史交互序列,预测用户下一个最可能交互的物品。
序列推荐系统的发展经历了从传统方法到深度学习方法的演进。早期方法主要基于马尔可夫链和矩阵分解,虽然简单但处理长序列和稀疏数据时表现不佳。随着深度学习的兴起,卷积神经网络(CNN)和循环神经网络(RNN)被引入该领域,但CNN难以建模序列依赖关系,RNN则存在梯度消失或爆炸问题,且计算效率较低。
基于自注意力机制的方法,如SASRec和BERT4Rec,通过计算序列中每对物品之间的依赖分数,在捕捉用户历史交互中的物品依赖关系方面表现优异。与CNN和RNN相比,自注意力机制不依赖固定窗口大小或递归结构,能够并行处理序列数据,具有显著优势。
2. 现有方法的局限性与论文要解决的问题自注意力机制虽然性能优异,但存在两个主要局限。
局限一:计算效率低。自注意力机制的复杂度是序列长度的平方级,即O(L的平方),其中L代表序列长度。随着序列长度增加,内存消耗和计算时间呈平方级增长,在处理长序列时计算效率低下且成本高昂。
局限二:泛化能力受限。自注意力机制缺乏结构性偏置,即没有对输入数据做任何结构性先验假设,甚至不感知位置和顺序信息,需要额外添加位置编码来建模序列顺序。这使得基于自注意力的方法容易过拟合噪声,影响泛化能力。已有研究实验证明,在某些任务中,原始Transformer的表现比引入强结构性偏置的方法低约30%。
为了解决上述问题,近期研究开始尝试用Mamba替换序列推荐器中的自注意力模块。Mamba是一种结构化状态空间模型,其独特的选择机制使其能够根据输入序列过滤噪声并保留相关信息,复杂度与序列长度呈线性关系,同时天然具备结构性偏置。
然而,Mamba在捕捉局部信息方面存在局限,单纯用Mamba替换自注意力会限制推荐任务的性能。更重要的是,现有方法仅将Mamba视为自注意力的替代品,忽略了二者之间潜在的互补性。在其他领域的研究已经证明,将Mamba与Transformer结合的混合框架往往优于单独使用任一模型,但这些发现能否直接应用于序列推荐仍有待验证,且这些研究仍使用复杂度为平方级的原始自注意力,削弱了Mamba的效率优势。
针对上述问题,作者提出了MLSA4Rec方法,其核心创新在于首次在序列推荐中探索Mamba与自注意力机制的结合潜力,设计了一个复杂度保持线性且充分发挥二者互补优势的混合框架。核心创新体现在以下三个方面: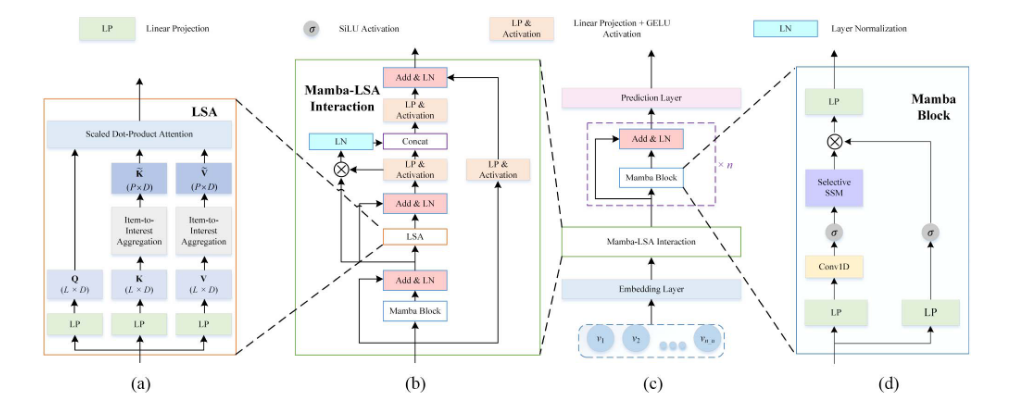
图1 MLSA4Rec方法整体概览
1. 首次将Mamba与自注意力结合用于序列推荐据作者所知,这是第一项在序列推荐乃至整个推荐系统中探索Mamba与自注意力机制结合潜力的研究。与现有仅用Mamba替换自注意力的方法不同,MLSA4Rec通过精心设计的交互机制让两者协同工作,同时确保整体复杂度相对于序列长度保持线性。这一混合框架的核心设计理念是:自注意力擅长捕捉局部依赖,Mamba擅长建模长程全局依赖,二者互补可以更全面地捕捉用户行为模式。
2. Mamba-LSA交互模块这是MLSA4Rec的核心组件,通过三个子机制实现Mamba与低秩分解自注意力(LSA)的协同交互。
第一个子机制是全局上下文聚合。Mamba模块首先处理输入序列,提取全局、顺序及其他相关信息,为后续的LSA模块注入结构性偏置,弥补自注意力缺乏结构先验的不足。
第二个子机制是局部上下文补充。虽然Mamba在捕捉全局和长程依赖方面非常有效,但可能忽略细粒度的局部上下文细节。LSA模块通过将物品映射到P个潜在兴趣,并建模单个物品与这些兴趣之间的复杂关系,有效补充局部信息。同时,LSA利用低秩特性将自注意力的复杂度从O(L的平方)降至O(P乘L),保持线性复杂度。
第三个子机制是门控信息传递。这是实现两者动态协调的关键。LSA模块通过门控机制学习重要性权重,动态引导Mamba聚焦于历史交互中的关键信息,使Mamba能够关注与用户当前兴趣最相关的交互。完成一次信息交互循环后,通过线性变换和激活函数将两者的输出进行融合,形成最终的综合性用户表征。
3. 曼巴归一化层在Mamba-LSA交互层之后,论文堆叠了n个曼巴归一化层,对交互后的信息进行进一步精炼和整合。这些层通过残差连接和层归一化,确保来自不同来源的信息被充分利用,更准确地反映用户偏好。实验表明,适当的归一化层数量能够有效提升模型性能。
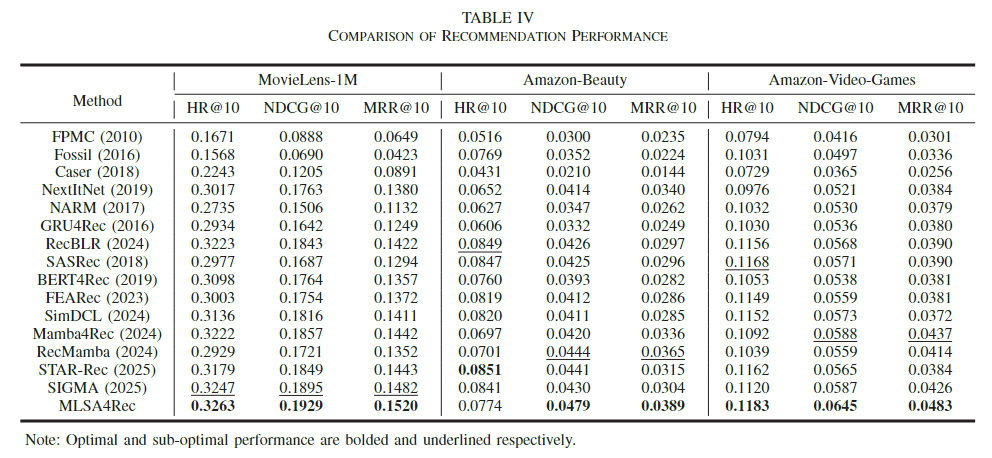
1. 显著的性能提升在MovieLens-1M、Amazon-Beauty和Amazon-Video-Games三个真实数据集上,MLSA4Rec与三类基线方法进行了全面对比,包括传统与神经网络方法、自注意力方法以及曼巴方法。结果表明,MLSA4Rec在大多数场景下均达到最优或次优性能。例如在MovieLens-1M数据集上,MLSA4Rec的HR@10达到0.3263,NDCG@10达到0.1929,MRR@10达到0.1520,均优于所有对比方法。在Amazon-Beauty数据集上,虽然HR@10略低于部分方法,但NDCG@10和MRR@10均达到最优,表明其在排名质量上具有显著优势。
图2 基于三个真实数据集的性能对比
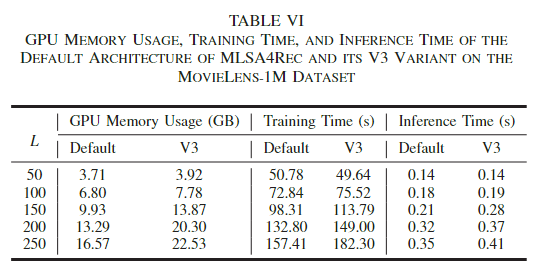
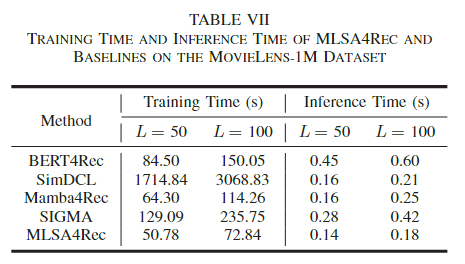
2. 卓越的计算效率MLSA4Rec的整体时间复杂度为O((n+1)LD平方 + PLD),约等于O(LD平方),相对于序列长度L呈线性关系,相较于原始自注意力的O(L平方D)有显著改进。空间复杂度主要由物品嵌入矩阵O(|V|D)和曼巴与LSA的投影参数构成,中间张量仅需O(LD)空间,同样与序列长度线性相关。实验验证了LSA相比原始自注意力在GPU内存使用、训练时间和推理时间上的全面优势,特别是在长序列场景下差异更加显著。与其他基线方法相比,MLSA4Rec的训练时间也显著优于BERT4Rec、SimDCL和SIGMA等方法。
图3 MLSA4Rec及其V3变体在MovieLens-1M数据集上的GPU显存占用、训练时间与推理时间
图4 MLSA4Rec与基线模型在MovieLens-1M数据集上的训练时间与推理时间
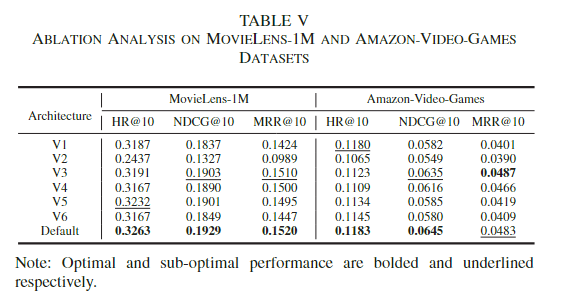
3. 充分的模块有效性验证消融实验验证了各个组件的必要性。移除Mamba模块导致性能大幅下降,在MovieLens-1M上HR@10下降约25%,说明Mamba模块对捕捉复杂用户行为模式至关重要。用原始自注意力替换LSA后性能接近,但LSA的优势在于避免物品间直接交互,增强抗噪声能力和泛化性能。移除门控交互机制后性能明显下降,说明门控机制对实现Mamba与LSA的动态协调不可或缺。曼巴归一化层同样对精炼用户偏好有重要贡献。
图5 基于MovieLens-1M与Amazon-Video-Games数据集的消融分析
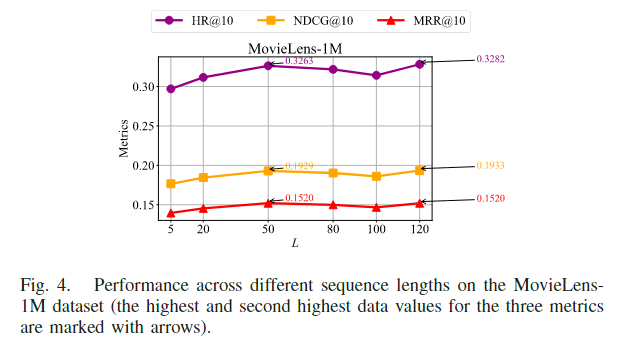
4. 长序列处理的强大能力在序列长度从5到120的范围内,MLSA4Rec的性能随序列长度增加而持续提升,HR@10在长度为120时达到0.3282的峰值,NDCG@10也呈现上升趋势。这充分证明了MLSA4Rec在长序列场景下有效捕捉长程依赖的能力,能够充分利用更长的用户历史信息来提升推荐质量。
图6 MovieLens-1M数据集上不同序列长度下的性能表现
这篇论文的核心是如何通过多机制协同来高效建模用户行为序列中的复杂依赖关系,这对AI知识管理有深刻的启示。
1. 多源知识融合的混合架构设计论文成功地将Mamba的全局依赖建模能力与自注意力的局部模式捕捉能力有机结合,证明了两类机制并非相互替代而是互补协同的关系。在知识管理系统中,面对复杂多样的知识资源,同样需要设计混合架构,将不同机理的知识编码器协同使用,例如结合图神经网络的关系建模能力与Transformer的序列建模能力,实现对异构知识更全面的表征。
2. 基于门控机制的动态知识选择门控信息传递机制使LSA模块能够动态引导Mamba聚焦于历史交互中的关键信息,实现了模型内部的注意力调度和资源分配。这一思想对知识管理系统有重要借鉴意义。在面对海量知识库时,系统需要动态评估不同知识片段与当前任务的相关性,通过类似门控机制的动态权重分配,筛选和聚焦最有价值的知识,从而提升知识检索和推理的效率与准确性。
3. 低秩分解在知识表示中的效率优化LSA模块通过低秩分解将自注意力的平方级复杂度降至线性,同时保持甚至提升了性能。这一效率优化策略对知识管理系统中大规模知识图谱或文档集合的表示学习具有借鉴价值。通过将知识实体投影到低维潜在空间,避免直接的全量交互计算,可以在保持表示质量的同时显著降低计算成本,支持更大规模知识库的高效管理。
4. 序列化知识路径的建模与预测序列推荐本质上是对用户知识或兴趣演化路径的建模与预测。在知识管理场景中,用户的求知路径、学习轨迹或研究主题演化同样具有序列特性。借鉴MLSA4Rec对长短期依赖的综合建模思路,可以构建用户知识状态演化模型,实现学习路径的个性化推荐、研究热点的趋势预测以及知识资源的时序化组织。
5. 理论驱动的模型设计方法论论文不仅通过实验验证了方法的有效性,还从偏差-方差权衡和集成学习的角度给出了Mamba与LSA互补性的理论解释,证明混合架构通过类似集成平均的方式降低表示方差,增强泛化能力。这一理论驱动的设计方法论值得AI知识管理系统借鉴——在设计系统架构时,不应仅凭经验试错,而应有理论依据指导,例如从知识表示的偏差-方差权衡出发,设计能够降低不确定性、提升鲁棒性的多源融合方案。
MLSA4Rec是一项具有开创性意义的混合序列推荐框架。它首次在推荐系统中系统性地探索了Mamba与自注意力机制的结合潜力,通过精心设计的Mamba-LSA交互模块,使两者发挥各自擅长领域的优势并相互补充,在保持线性计算复杂度的前提下实现了超越现有方法的推荐性能。该论文发表在IEEE TKDE这一顶级期刊上,充分体现了其研究工作的创新性和学术影响力。对于AI知识管理领域,其核心思想——通过混合架构融合不同机制的互补优势、通过门控机制实现动态信息选择、通过低秩分解实现效率优化、以及理论驱动的设计方法论——具有重要的参考价值和迁移潜力。
《IEEE Transactions on Knowledge and Data Engineering》(简称 IEEE TKDE)该期刊创刊于1989年,是知识工程与数据管理领域国际公认的顶级期刊之一。根据2026年6月发布的最新数据,该期刊影响因子为10.2,五年影响因子为11.9,在JCR分区中位列Q1区,中科院分区为计算机科学1区TOP期刊,同时被中国计算机学会(CCF)列为人工智能领域A类推荐期刊。该刊涵盖数据挖掘、知识发现、数据库系统、人工智能、推荐系统等多个方向,H-index指数为169,是数据管理与知识工程领域最具影响力的期刊之一。